在当今的大数据时代,各种数据如雨后春笋般涌现,如何从中提炼出有价值的信息成为了一个关键课题。机器学习中的无监督学习算法以其独特的魅力逐渐崭露头角,尤其在没有明确标签的情况下,它可以帮助我们从海量信息中挖掘潜在模式。
无监督学习算法的背景
想象一下,你在一片未知的丛林里探险,手中只有地图和指南针两个工具。这就是数据科学家面对未标记数据时的情形:手中有了一大堆的信息碎片,却不知道如何从这些碎片中拼凑出一幅有意义的地图。这时,无监督学习算法就像那个聪明的小探险家手中的魔杖,能够通过一定的规则自动发现数据中的规律。
无监督学习算法的应用场景
文本挖掘
在社交媒体分析中,人们每天都在生成大量的文本数据。传统的做法是人为地标注这些数据,但这显然是不切实际的。这时,无监督学习算法如聚类、主成分分析(PCA)等就可以大显身手了。它们能够在没有标签的情况下自动对这些文本进行分类或降维处理。
图像识别
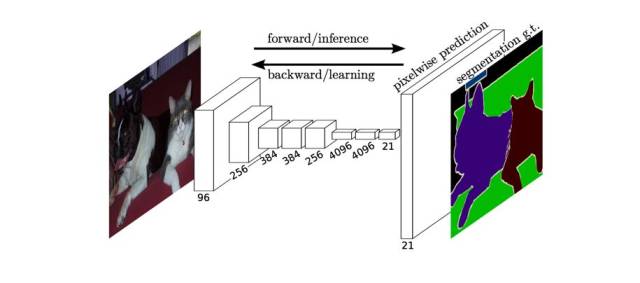
在图像领域,无监督学习算法可以帮助我们揭示图片中的模式和结构。比如,通过训练一个自编码器模型,我们可以从大量的未标注的图片中提取出特征表示,进而实现更好的图像分类效果。
无监督学习的动态与挑战
随着技术的进步,无监督学习算法也在不断发展和完善。最新的研究表明,深度生成模型、变分自编码器等方法在复杂数据集上的表现更加出色。但是,这些模型通常需要大规模的数据支持,并且对计算资源的需求较高。
此外,在实际应用中面临的挑战也不少。例如,如何判断一个无监督学习算法的表现好坏?目前并没有像监督学习那样明确的评价标准。又如,过拟合问题在无监督学习中也较为常见,因为模型需要从数据中自动学习到尽可能多的信息。
结论
总的来说,尽管遇到了一些挑战,但随着技术的发展和应用场景的拓展,无监督学习算法将在未来的数据分析领域扮演越来越重要的角色。它就如同一把打开知识宝藏的大门钥匙,帮助我们在海量的数据海洋中自由航行,探索未知的世界。